Gentle-AI: lo que le falta a Claude Code, OpenCode y Codex
Gentle-AI: lo que le falta a Claude Code, OpenCode y Codex
Configura el agente que ya usas con ODD, RDD, Engram, skills, permisos y persona. Te muestro cómo funciona cada pieza y cómo instalarlo.
📝 En resumen: Gentle-AI es un ecosistema que se instala sobre el agente que ya usas (Claude Code, OpenCode, Codex…) y le suma una metodología de trabajo (ODD), revisiones para cambios de alto riesgo (RDD), memoria con Engram, skills, permisos y personalidad. Si solo quieres instalarlo, salta a Cómo instalar Gentle-AI.
Anteriormente te comentaba cómo he usado Engram en mis flujos de trabajo y cómo funciona para darle memoria a tus agentes. Ahora quiero continuar con otras de las herramientas del mismo autor, Alan Buscaglia, o como le llama la comunidad: el Gentleman. Llevo ya un tiempo usando estas herramientas, que de hecho están teniendo muy buena acogida en la comunidad hispana y empiezan a tener cierto momentum en la comunidad de habla inglesa. Ahora sí, hablemos de Gentle-AI.
📌 Nota: este es un proyecto muy activo, desarrollado por el Gentleman y la comunidad, por lo que puede que varíe un poco en el futuro. En este artículo comentaremos la versión disponible a la fecha, es decir, la
4.4.0.
¿Qué es Gentle-AI? 🌹
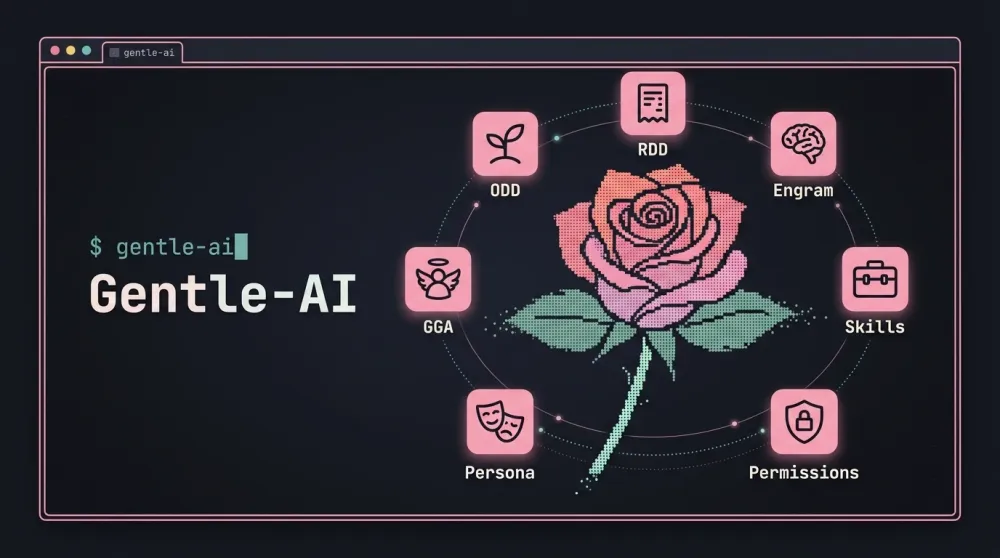
Se define como un ecosistema de múltiples herramientas que se integran a tu agente de IA de confianza. Actualmente soporta 17 agentes diferentes, entre ellos: Claude Code, OpenCode, Codex, Kimi Code, etc.
⚠️ Ojo: Gentle-AI no es un agente de IA, ni un harness, ni un modelo LLM.
Herramientas que integra:
- ODD (Organic Driven Development): es una metodología de trabajo propia, así que no la encontrarás en ningún libro.
- RDD (Receipt-Driven Development): es una metodología para revisar los cambios de alto riesgo que se realizaron.
- Engram: le da memoria a tus agentes usando una base de datos SQLite. Te invito a que leas mi otro artículo para entender cómo funciona y cómo te ayuda en tu desarrollo.
- Skills: un conjunto de skills que te ayudarán en tu día a día.
- Permissions: dependerá del agente, pero en síntesis se configura para que el agente deje de pedir confirmación en cada cambio y, a la vez, instala un conjunto de limitantes para bloquear operaciones peligrosas como la lectura de archivos
.env, secretos, llaves SSH y acciones destructivas. Además, agrega otros patrones en los que sí solicitará tu aprobación, comonpm publishogit push, entre otros. - Persona: instruye a tu agente para que tenga determinada personalidad en sus respuestas.
- GGA (Gentleman Guardian Angel): lo que hace es que, antes de hacer commit, los archivos en staged se validan contra las reglas que has establecido en tu
AGENTS.md.
Desglosemos uno a uno y luego, si te he dado la curiosidad suficiente para que lo pruebes, te explicaré cómo lo puedes instalar.
Organic Driven Development (ODD) 🌱
La idea de esta metodología es remover las fases protocolarias que suelen tener otras metodologías. ¿A qué me refiero? Bueno, por ejemplo, en SDD (Spec-Driven Development), una vez que lo eliges, debes pasar por propuesta, especificación, diseño y tareas sin importar el tamaño del feature solicitado. Con ODD, la idea es que simplemente solicites un cambio directamente, sin escribir un comando tipo /odd o algo por el estilo.
Al escribir ese primer prompt que le enviamos al agente, pasaremos por los siguientes 7 pasos. Ojo, no son fases que tengas que aprobar una por una: el agente las recorre solo y, en un cambio pequeño, varias se resuelven en segundos o ni siquiera aplican.
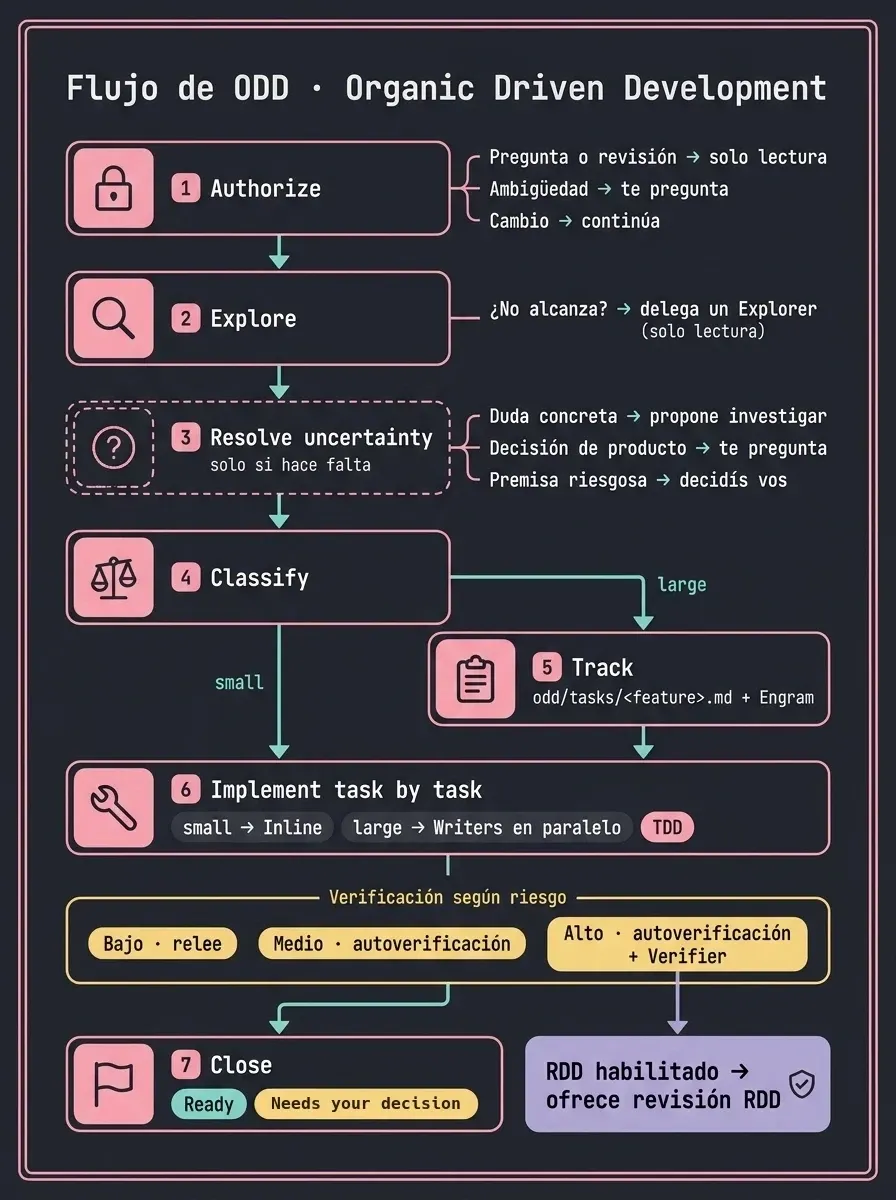
1. Authorize: decide si el agente tendrá permisos de escritura o no. Si es una pregunta o una revisión, se queda en solo lectura. Si hay ambigüedad, hará una pregunta.
2. Explore: explora el código y los requerimientos para ayudar a decidir si es un cambio pequeño o grande, qué se hará y dónde. Si después de una primera exploración de máximo unas 3 llamadas a herramientas y unos 10k tokens consumidos aún hace falta explorar más, se delega a un agente explorer de solo lectura para completar la exploración.
3. Resolve uncertainty: este paso solo se ejecuta si, con lo que se exploró en el paso anterior:
- Aún queda alguna duda concreta. Entonces propondrá una investigación adicional.
- Aún queda alguna decisión de producto o de diseño sin resolver (no técnica). Entonces te hace la pregunta.
- Existe una premisa que tendría graves consecuencias si fuera falsa. Por ejemplo: “Crea una migración que borre la columna
legacy_email, ya nadie la usa.” Si no fuera cierto que ya no se usa, perderíamos los datos y tendríamos errores en el sistema. En un caso así, el agente te muestra la premisa, la evidencia y la posible consecuencia, y la decisión queda en ti.
4. Classify: se determina si será un cambio grande o pequeño, y si llevará verificador o no. Se considera un cambio pequeño solo si se cumplen estas 3 condiciones:
- Understood: se sabe qué y dónde cambiar, no hay decisiones abiertas y lo demuestra con una sola tanda de lectura.
- Contained risk: no toca ninguna de las 6 categorías de riesgo, que te enlisto más adelante.
- Resumable from the diff: si la sesión se cortara ahora, alguien podría terminarlo solo con la solicitud original y el
git diff.
Se considera un cambio grande únicamente si no se cumple la condición Resumable from the diff, es decir: requiere varias sesiones, esperar algo externo o requisitos tan largos que no sobreviven una compactación.
Se determina que el cambio requerirá un agente verificador únicamente si toca alguna de las 6 categorías de riesgo.
5. Track: si es grande, crea odd/tasks/<feature>.md y su copia en Engram antes de tocar código. La estructura de este archivo es: un encabezado de 2 o 3 líneas (objetivo, branch, estrategia de entrega y runner de tests), luego ## Specs, ## Tasks y ## Log.
Un ejemplo sería:
Objective: add retries to upload handler · Branch: feat/upload-retries · Delivery: ask-on-risk · Runner: go test
## Specs
- S1: "que reintente 3 veces si falla la subida" (palabras exactas del usuario)
## Tasks
- [x] T1 (S1) retry with backoff, commit a1b2c3d
- [ ] T2 (S1) surface final error
## Log
- L1: <petición original, literal>
6. Implement task by task: si el cambio solicitado se clasificó como pequeño, el agente lo realiza directamente, sin delegar subagentes, es decir, inline. Si se clasificó como grande y hay 2 o más unidades de trabajo independientes y pesadas (varios archivos o unas 100 líneas cada una), se delegan agentes en paralelo, uno por unidad, a los que se les llama writers. Si no, también se hace inline. Cada writer tiene archivos permitidos en los que puede escribir, sin que se crucen con los de sus compañeros. Ningún writer ejecuta formateadores como Prettier ni instala dependencias nuevas, eso lo realiza el agente principal, el orquestador.
La implementación se realiza con TDD (Test-Driven Development) cuando aplica a lo que estamos implementando. Si no conoces TDD, te lo describo brevemente:
- Empiezas escribiendo un test para una funcionalidad que aún no existe.
- Al ejecutarlo, claramente la prueba falla.
- Ahora sí implementas el código mínimo para la funcionalidad que se está probando.
- Ejecutas el test y ahora sí debe pasar.
La idea es reducir la sobreingeniería y los errores y bugs desde las fases tempranas del desarrollo.
Conforme se completan las tareas descritas en el archivo .md, se van marcando, pero únicamente si se observaron sus resultados y sus checks. También se agrega una línea que indica el riesgo asociado a la tarea realizada. El riesgo puede ser de 3 niveles:
- Alto: se considera alto si se realizaron cambios en cualquiera de las siguientes 6 categorías:
- Datos o efectos irreversibles: migraciones, cambios o eliminación de datos almacenados. Por ejemplo, escribir una migración que borra una columna de la base de datos.
- Seguridad: todo lo relacionado con la lógica de quién puede hacer X dentro del sistema. Por ejemplo: autenticación, autorización, permisos, credenciales, secretos, etc.
- Contratos: cambios sobre algo de lo que alguien más ya depende, ya sea otro sistema externo, otro equipo u otro usuario. Por ejemplo: cambiar o remover una API pública, una CLI o los exports del sistema.
- Concurrencia: errores que ocurren solo a veces, según el orden en que se ejecutan las cosas. Por ejemplo, una race condition o features relacionados con la idempotencia o la invalidación.
- Entrega o entorno: dónde se ejecuta el código y cómo se corre. Por ejemplo: workflows de CI/CD, Dockerfiles, manifiestos de Kubernetes, entre otros.
- Ningún test detectaría una regresión: esta categoría no depende del tipo de cambio realizado, sino de si el código es confiable, y responde a la pregunta: si dejara de funcionar, ¿tengo algún mecanismo que me indique que dejó de funcionar? Si la respuesta es no, entra en esta categoría. Por ejemplo: cualquier parte del código sin tests o un layout visual sin tests visuales.
- Pasivo o bajo: imágenes o documentación, pero que lea un usuario, no instrucciones para un agente (como un
AGENTS.mdo unCLAUDE.md). Por ejemplo: unREADME.mdo una captura de pantalla. - Medio: todo lo que no es ni de riesgo alto ni bajo, es decir, un cambio “normal” en el código.
El tipo de verificación también cambia según el nivel de riesgo:
- Pasivo o bajo: relee lo que se escribió y comprueba que contiene lo que se pretendía y que está bien formateado.
- Medio: el agente que hizo el cambio realiza una autoverificación. Si fue el agente principal (inline), ejecuta directamente los tests de los cambios. Si el cambio lo hizo un subagente writer, el agente principal recibe los comandos exactos que usará para la verificación. Hay un intento de corrección por cada check que falle y un segundo intento si vuelve a fallar el mismo check.
- Alto: se realiza una autoverificación como en el nivel medio y se delega un subagente verificador que busca contestar la pregunta: ¿se cumple lo que pidió el usuario? Para eso genera sus propios tests a partir de la especificación original, no a partir del código generado por el writer. Luego genera un informe que indica, requerimiento por requerimiento, si se cumple o no, con la evidencia de las pruebas. El agente principal recibe el informe, delega las correcciones y se vuelve a verificar. Si aún quedan correcciones pendientes, se vuelven a delegar. Si después de 2 rondas de correcciones la verificación no pasa, te presenta un mensaje como el siguiente:
⚠️ Needs your decision. T2 feat(auth): validate refresh token (a1b2c3d).
Después de 2 rondas de corrección, el verificador sigue reportando S2 sin cumplir: un token expirado sigue siendo aceptado.
Impacto: la tarea no puede cerrarse como Ready sin esa evidencia.
Opciones: corregir a mano y volver a verificar, ajustar la especificación S2 o dejar la tarea pendiente.
Si tienes habilitado RDD en la configuración de Gentle-AI, es justo al terminar la verificación que se te ofrecerá ejecutar una revisión RDD. Más adelante, en la sección de RDD, te muestro cómo luce ese mensaje.
Si quieres ver cómo luce uno de estos archivos ya en uso, con sus tareas, su avance, el riesgo de cada una y el log que lo registró todo, checa este archivo real del propio repositorio de Gentle-AI: odd/tasks/task-size-canon.md.
Así llegamos al último paso de ODD.
7. Close: acá el agente debe rendir cuentas, indicando qué quedó comprobado y qué no, y cuáles son los siguientes pasos, como podría ser hacer push, crear el PR o hacer merge. Esta fase puede terminar como:
- Ready: todo lo requerido quedó verificado.
- Needs your decision: quedan blockers abiertos o falta evidencia de que se completaron los requerimientos.
Realmente no necesitas comprender cada paso para usar ODD. Lo único que necesitas es escribirle a tu agente y él hará el resto. Verás cómo esta forma de trabajar te resultará “orgánica” o natural en tu día a día. 🌱
Receipt-Driven Development (RDD) 🧾
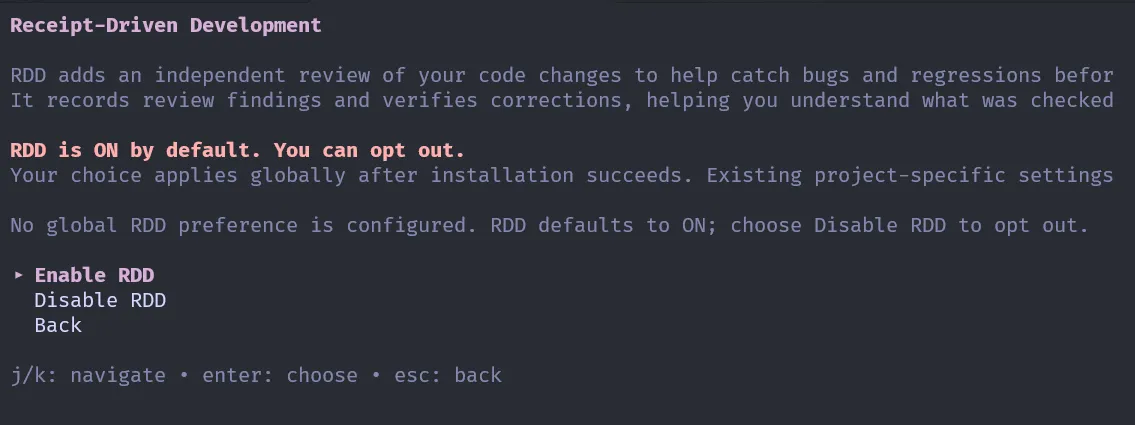
RDD es completamente opcional: puedes deshabilitarlo globalmente o, si lo tienes habilitado, puedes rechazar las propuestas de revisión que se te hagan.
Su significado vendría a ser algo así como una entrega condicionada a un comprobante de revisión. La idea es que, antes de empezar a revisar, se toma una especie de snapshot, una foto inmutable de los cambios actuales. Esto evita que se revise código en el que otro agente está trabajando activamente, lo que daría un resultado erróneo.
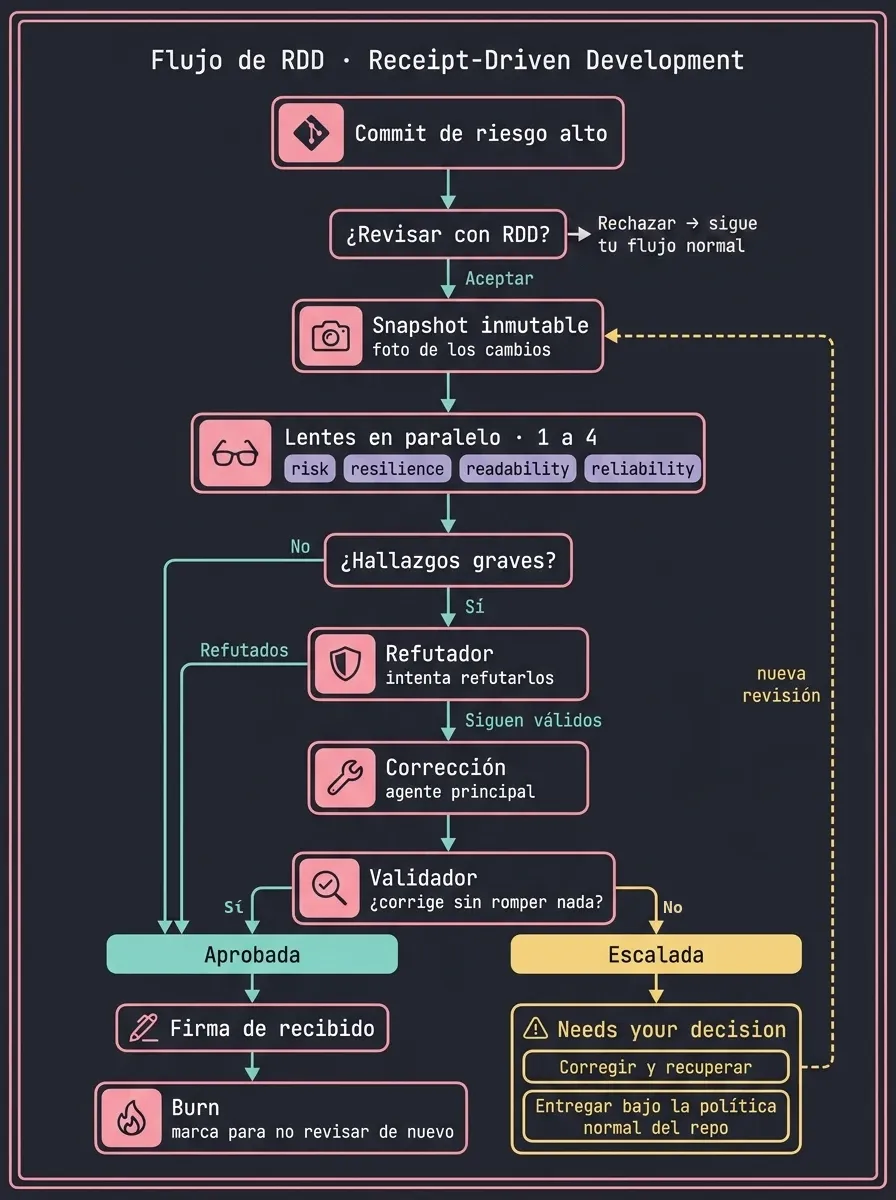
Luego de que se hace el commit de una unidad de trabajo identificada como un cambio de riesgo alto, se te muestra un mensaje que te ofrece hacer la revisión de código con RDD. Luciría algo así:
Gentle AI can review this change before you call it done.
Why: Review can help identify potential security issues.
Reviewing takes a little longer and makes the result safer.
  1) Review this change
  2) Skip this time
To turn reviews off for good, run 'gentle-ai review mode disable'.
Choose 1 or 2 [1]:
Si eliges Skip this time, se omite solo para ese cambio y las revisiones futuras siguen habilitadas.
Si aceptas la revisión propuesta, el agente principal elige al menos uno de los lentes o especializaciones para la revisión, y pueden correr hasta 4 en paralelo. Las 4 especializaciones disponibles son:
- risk: si algo queda expuesto, se pierde o cambia de forma irreversible. Es decir, todo lo relacionado con seguridad, autorización, exposición o pérdida de datos, input inseguro, secretos y vulnerabilidades de dependencias.
- resilience: cómo se comporta cuando algo falla. Todo lo relacionado con manejo de fallos, rollback, reintentos seguros, degradación, observabilidad, latencia y carga.
- readability: lo que otros leen o de lo que dependen. Todo lo relacionado con nombres engañosos, lógica duplicada o muerta, constantes sin explicar, complejidad riesgosa y falta de contexto.
- reliability: lógica o comportamiento que los tests deberían fijar. Es decir: comportamiento, tests, límites, inputs inválidos, caminos de fallo, determinismo y regresiones.
Al completarse cada revisión, los hallazgos pasan a un subagente refutador, que intenta refutar los hallazgos graves. Si después de intentarlo los hallazgos siguen siendo válidos, el agente principal implementa la corrección. Luego, un subagente validador comprueba si la corrección realmente resuelve el hallazgo y si no se rompió algo más en el proceso.
Después del validador, la revisión solo puede terminar aprobada o escalada.
Aprobada: se le devuelven al agente principal los resultados y hallazgos de cada revisor o del validador final, junto con una solicitud de confirmar de recibido. El agente principal “firma de recibido”, es decir, ejecuta un comando que registra el cambio de estado de la revisión. Al firmar de recibido se ejecuta el burn o quemado del expediente de la revisión, y lo único que deja es una marca para no volver a revisar el mismo cambio.
El objetivo de pedir una firma de recibido es persistir los resultados y hallazgos de RDD hasta que el agente confirme que los recibió. Así, incluso si la sesión con el agente se cerrara en ese momento, al retomarla regresamos al mismo punto donde nos quedamos.
Escalada: ocurre cuando:
- No resolvió el problema o rompió algo en el proceso.
- La corrección excedió el presupuesto de líneas que podía cambiar.
- Hay un hallazgo grave sin evidencia suficiente.
- Quedaron hallazgos graves sin resolver.
Entonces te mostraría un mensaje como el siguiente:
⚠️ Needs your decision. T2 feat(auth): validate refresh token (a1b2c3d). La revisión RDD se escaló: targeted_validator_rejected. Hallazgo CRITICAL de risk, confirmado por el refuter: un token expirado sigue siendo aceptado. La corrección no cubrió el caso.

Opciones: corregir y recuperar la revisión o entregar bajo la política normal del repo.
Corregir y recuperar la revisión: ya sea que corrijas el código a mano o lo haga el agente principal, le indicas al agente que se realizó la corrección y se inicia una nueva revisión RDD, que puede terminar aprobada o escalada.
Entregar bajo la política normal del repo: si ya no quieres seguir peleando con la revisión, simplemente la dejas hasta ahí y continúas con tu flujo de trabajo, ya sea commit, push o lo que desees.
Skills 🧰
Gentle-AI divide las skills en Review Skills y Foundation Skills.
Review Skills
Judgment Day: esta es, a mi parecer, la skill más interesante. ⚖️
Cómo funciona:
- Se delegan dos jueces que revisan el mismo código en paralelo, sin ver el resultado del otro.
- Solo tienen permisos de lectura.
- Revisan edge cases, manejo de errores, rendimiento, seguridad y convenciones del proyecto.
Cómo se concilian los hallazgos:
- Si ambos confirman un problema grave, te pregunta y luego otro agente,
jd-fix-agent, lo corrige. - Si solo uno lo reporta, queda como suspect y no se corrige.
- Si se contradicen, te pide decidir a ti.
- Luego de las correcciones, vuelve a delegar a los 2 jueces y reinicia la conciliación.
- Este flujo de juicio y conciliación se repite como máximo 2 rondas.
- El resultado final es
APPROVEDoESCALATED.ESCALATEDsignifica que después de la segunda ronda quedaron problemas sin resolver, así que se detiene y te toca decidir a ti.
Para usar esta skill debes pedirla directamente con “judgment day” o “juzgar” dentro del prompt.
Foundation Skills
Go Testing
- Para qué: patrones de tests en Go: cobertura, tests de TUI hechas con Bubble Tea (
teatest) y golden files. - Cómo se usa: se carga al escribir o revisar tests de Go. Solo sirve en proyectos Go.
Gentle AI Bench
- Para qué: es para quienes contribuyen a Gentle-AI, probablemente no la necesites.
Skill Creator
- Para qué: crear skills nuevas pensadas para que las lea un LLM, con un frontmatter válido.
- Cómo se usa: cuando un patrón se repite, por ejemplo: “crea una skill para mi flujo de publicación de artículos”.
Skill Improver
- Para qué: auditar y mejorar archivos
SKILL.mdque ya existen. - Cómo se usa: “audita mis skills”. Por defecto solo audita, no cambia nada.
Branch & PR
- Para qué: preparar ramas y PRs siguiendo la política de contribución del repo destino.
- Cómo se usa: le pides algo como “prepara el PR”. No hace commit,
push, PR ni merge automáticamente.
Issue Creation
- Para qué: redactar, crear, comentar, clasificar o aprobar issues de GitHub, con evidencia sacada del repo.
- Cómo se usa: “abre un issue con este bug”.
Skill Registry
- Para qué: indexar las skills disponibles (trigger y ruta) en
.atl/skill-registry.md. Es la pieza que permite pasarle a cada subagente las rutas exactas de sus skills. - Cómo se usa: después de instalar, crear, mover o renombrar skills: “actualizar skills”.
Chained PR
- Para qué: dividir cambios grandes en PRs encadenados o stacked PRs, para que cada revisión sea manejable.
- Cómo se usa: se activa cuando un PR pasa las 400 líneas cambiadas, o cuando el conteo de un feature de ODD supera unas 400. También si pides “stacked PRs”.
Cognitive Doc Design
- Para qué: te apoya con la documentación: guías, READMEs, RFCs, onboarding y documentos de arquitectura.
- Cómo se usa: se carga al crear o editar documentación que alguien tiene que entender o usar durante una revisión.
Comment Writer
- Para qué: te apoya con feedback en PRs, respuestas a issues, reviews, Slack y GitHub.
- Cómo se usa: se activa cuando, por contexto, entiende que es un comentario que leerá otra persona.
Work Unit Commits
- Para qué: planear commits como unidades revisables, es decir, un comportamiento con sus tests y su documentación. Es la base de los commits por unidad de trabajo de ODD.
- Cómo se usa: al decidir qué va en cada commit o PR. ODD la usa en el trabajo grande.
RDD Defect Workflow
- Para qué: guiar el trabajo sobre issues del propio RDD.
- Cómo se usa: está pensada para mantenedores o para quien contribuye con RDD.
Systemic Issue Triage
- Para qué: agrupar los bugs por causa raíz en vez de parchearlos uno por uno.
- Cómo se usa: al clasificar issues nuevos, planear arreglos de un backlog o responder un reporte de bug.
Tú decides cuáles instalar según tus necesidades.
Persona 🎭
Gentle-AI te da a elegir las siguientes opciones:
- Gentleman: tu agente tendrá una personalidad de mentor o guía, que te indica cómo evitar malas prácticas y te explica el porqué, pero con un poco de esa jerga argentina (claro, eso en español, en inglés no sé bien si transmite lo mismo 🤔). Como si el propio Gentleman te estuviera hablando.
- Neutral: la misma personalidad de mentor, pero sin ese toque argentino, manteniéndose profesional.
- Custom: mantiene la personalidad nativa del agente.
Cómo instalar Gentle-AI 🛠️
Si te ha llamado la atención este ecosistema de herramientas, lo podrás probar de la siguiente manera. Si estás en Linux o macOS:
# macOS (Homebrew)
brew install gentleman-programming/tap/gentle-ai
Para Windows tiene soporte nativo sin usar WSL, pero requiere que tengas Go instalado. Para eso te recomiendo que lo instales con Scoop, piénsalo como el Homebrew de Windows.
# Instala Go
scoop install main/go

# Windows (PowerShell)
go install github.com/gentleman-programming/gentle-ai/v4/cmd/gentle-ai@latest
Para abrir la TUI integrada y configurarlo, escribe:
gentle-aiVerás algo como esto:
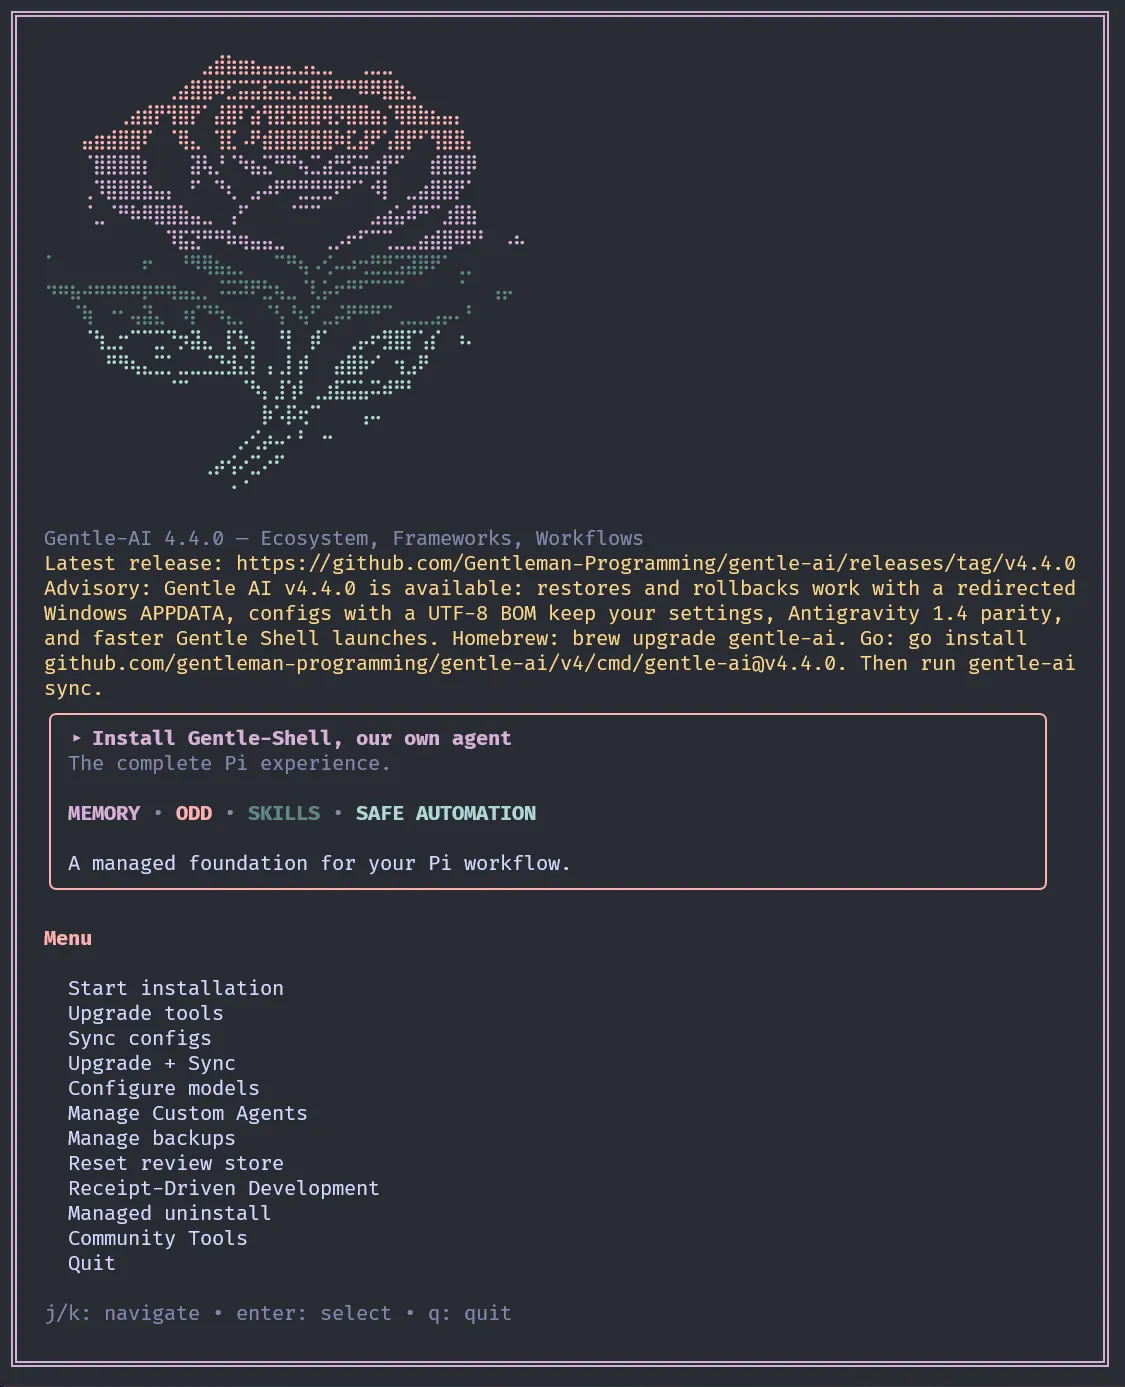
Verás que habla de Gentle Shell: este es todo un harness que ya trae ODD y algunas otras herramientas que integra la comunidad. Por ahora centrémonos en la instalación de Gentle-AI, en un próximo artículo abordaré Gentle Shell con más detalle. Para iniciar la instalación, muévete con las direccionales hasta la opción del menú Start installation y presiona Enter.
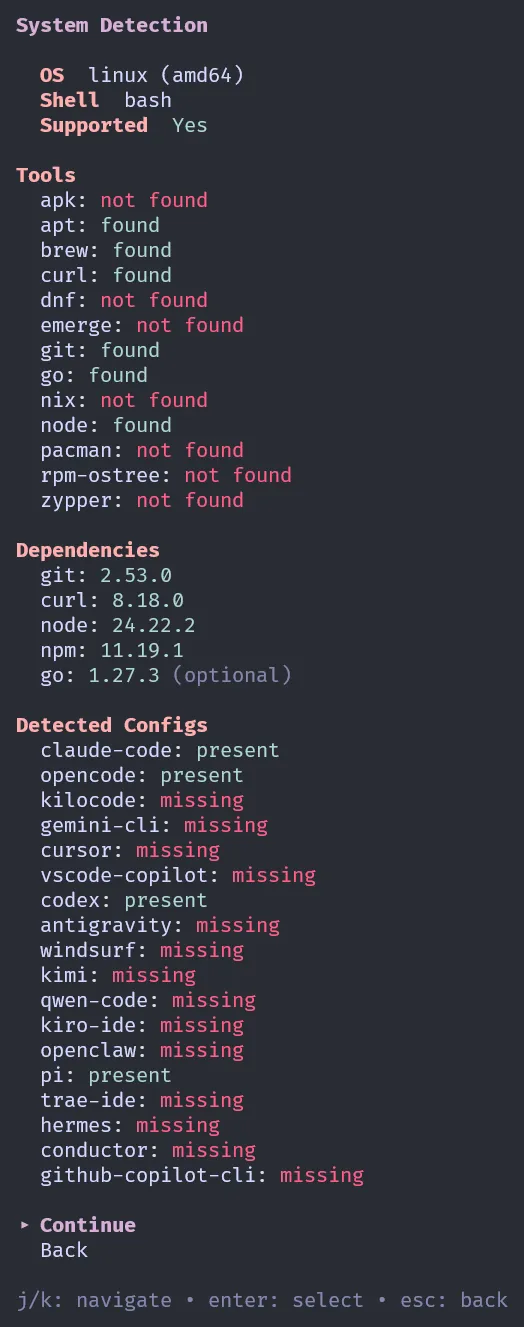
Verificas que el harness que vas a usar se haya detectado correctamente y continúas presionando Enter.
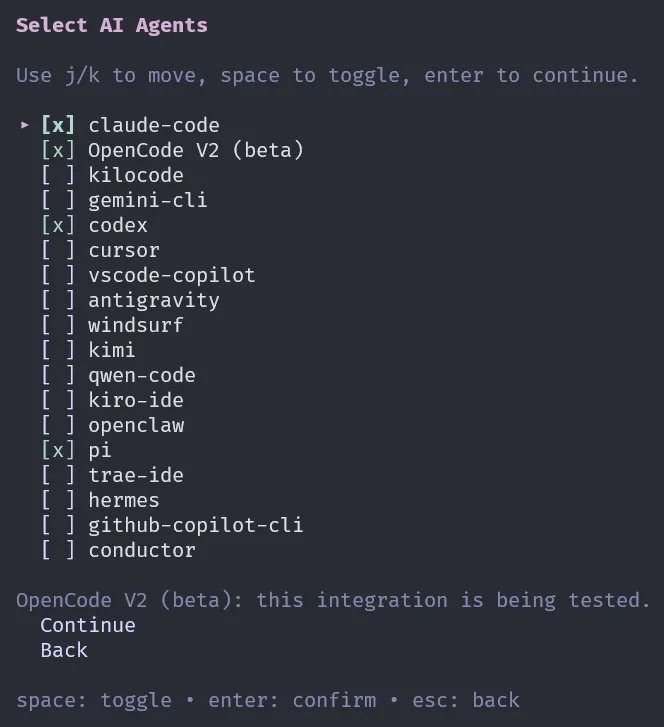
Gentle-AI te va a preseleccionar los agentes que ya detectó. Si no quieres que se instale en alguno de tus agentes, muévete con las direccionales hasta ese agente y presiona Space para deseleccionarlo.
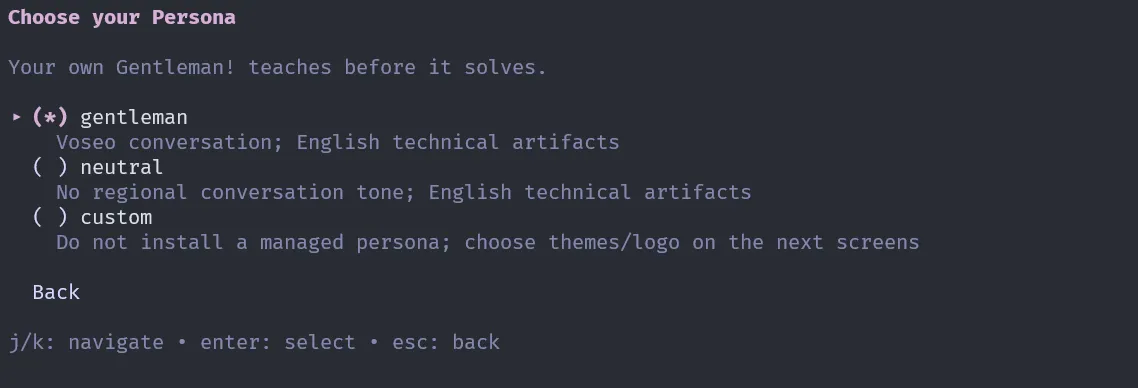
Selecciona el tipo de Persona que deseas instalar y presiona Enter. Yo prefiero Neutral, pero tú puedes usar la que gustes.
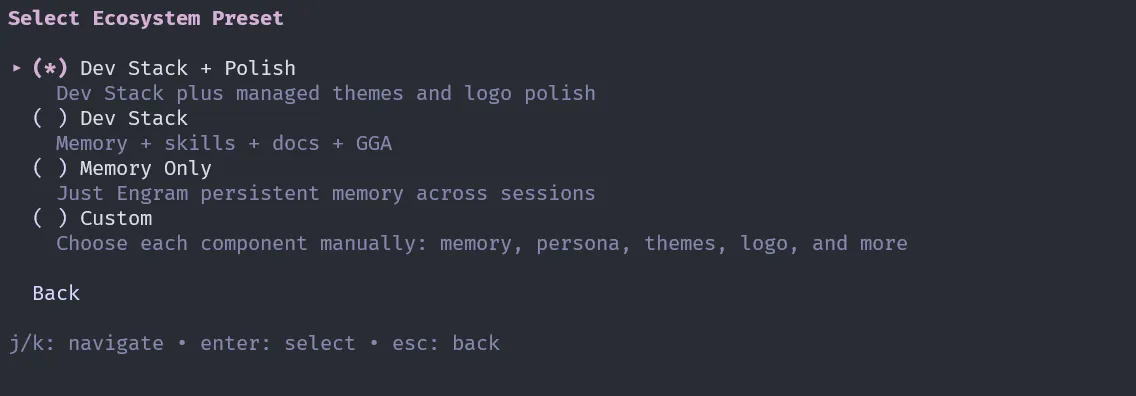
En este punto yo prefiero irme por Custom para seleccionar cada componente manualmente, pero si algún preset ya cumple tus necesidades, selecciónalo y presiona Enter.
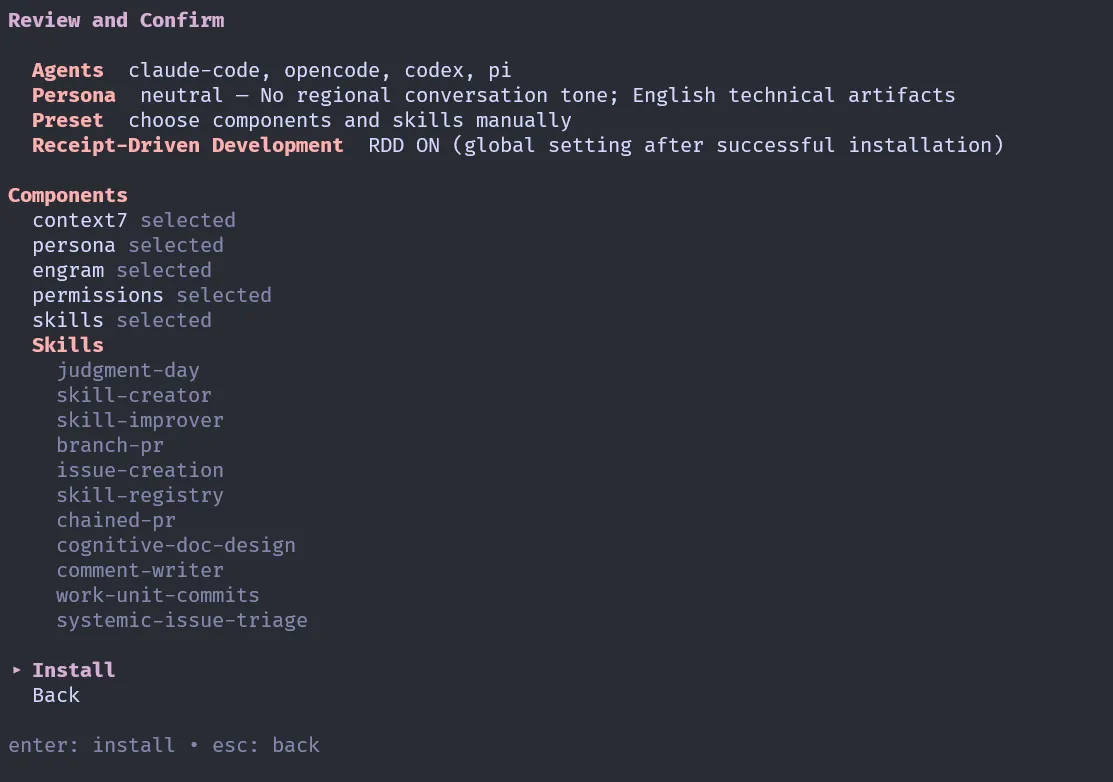
Si seleccionaste Custom como yo, te llevará a elegir qué componentes deseas instalar. Yo los suelo seleccionar de la siguiente manera:
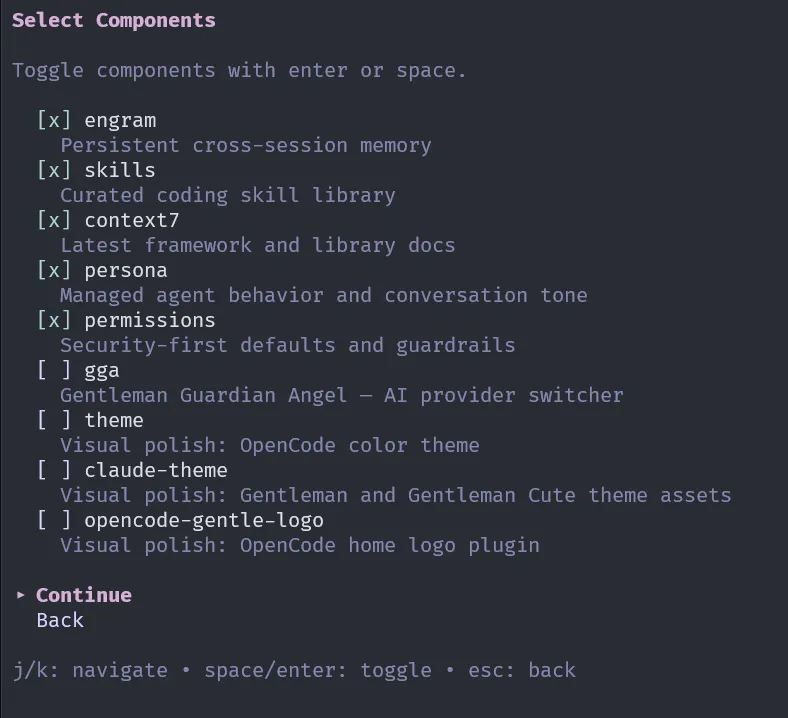
Te recomiendo que incluyas Context7, que le da a tu agente acceso a la documentación de una gran variedad de librerías, dependencias y tecnologías. 📚
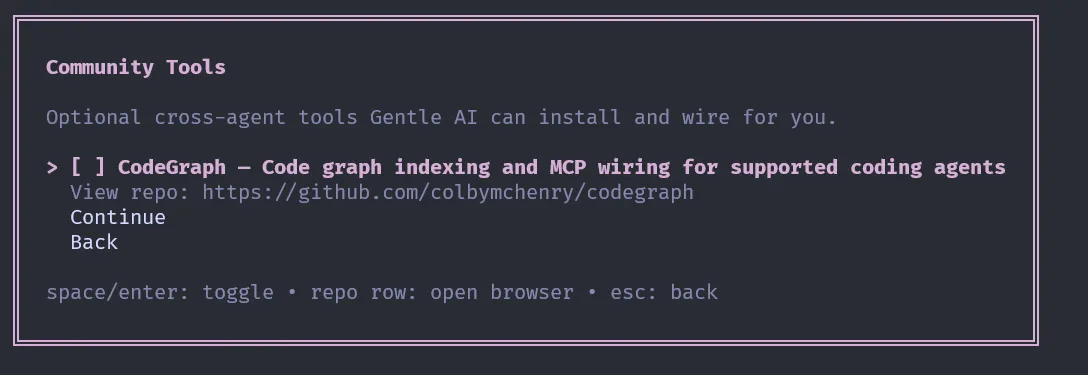
Luego se te ofrece la siguiente Community Tool, por si deseas instalarla.
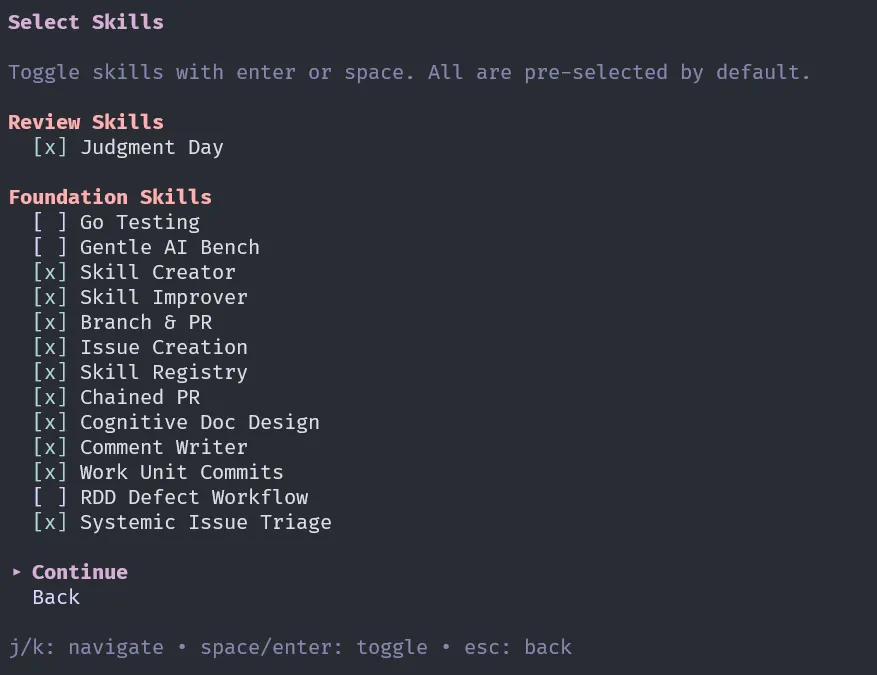
Y procedes a seleccionar las skills que desees. En mi caso, como no suelo programar en Go ni soy un contribuidor activo de Gentle-AI, luciría de esta manera:
Ahora puedes habilitar o deshabilitar RDD de forma global. Esta configuración la puedes cambiar después si cambias de opinión.
Confirmas que todo esté bien y procedes a instalar.
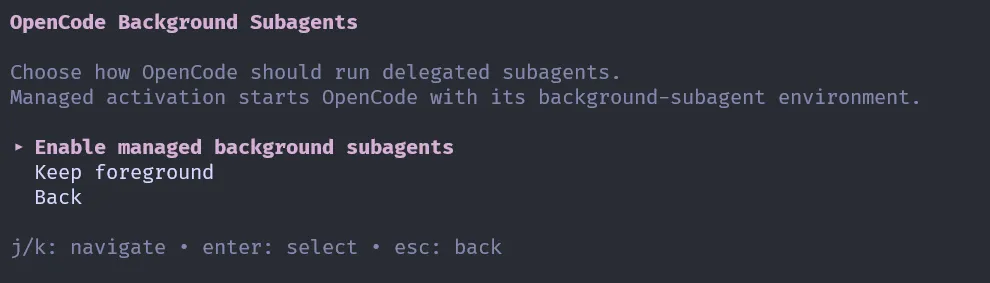
Si OpenCode está entre los agentes que seleccionaste, es posible que se te muestre la siguiente opción. Yo la suelo habilitar:
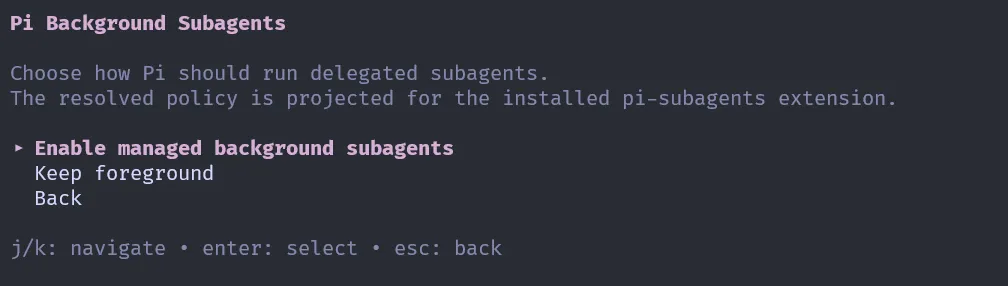
Lo mismo para Pi Agent:
Cuando termine la instalación, presiona Enter para regresar al Home de la TUI.
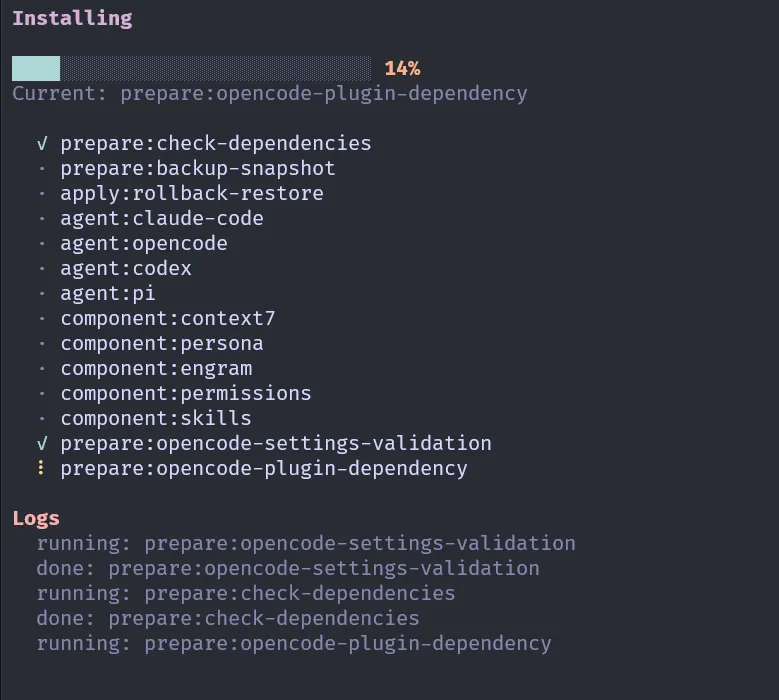
Ahora solo te queda probarlo: abre tu agente o harness y háblale como de costumbre. 🚀
Sincroniza y elige tus modelos 🔄
Cuando recibas una actualización, será necesario sincronizar de nuevo las configuraciones. Para ello puedes ejecutar gentle-ai sync en la terminal, o abrir la TUI de Gentle-AI e ir a Sync configs o Upgrade + Sync.
Si vas a Configure models:
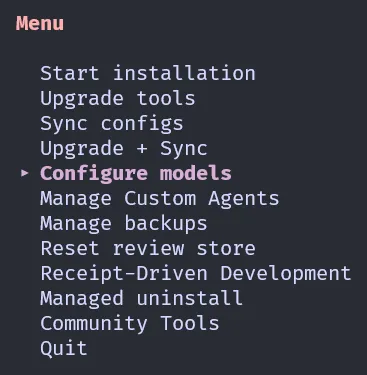
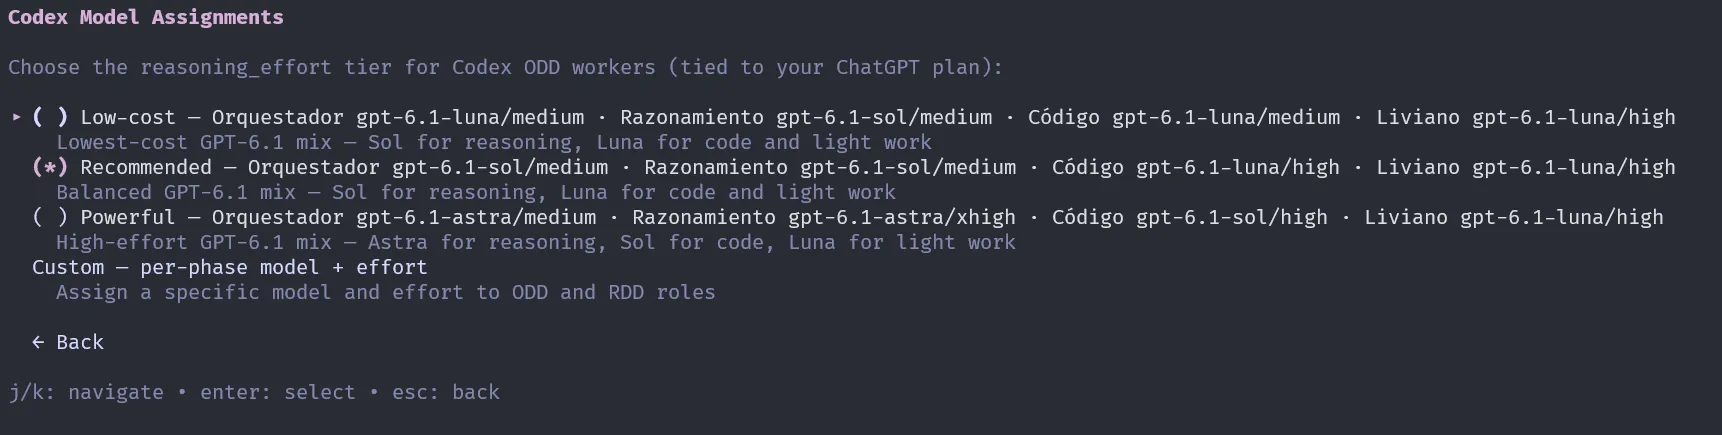
Podrás configurar qué modelos se usarán en cada harness que tengas, según el perfil que necesites.
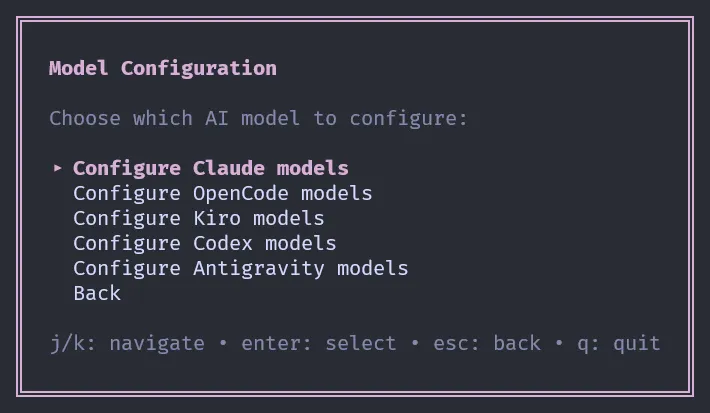
Ejemplo con Claude Code:
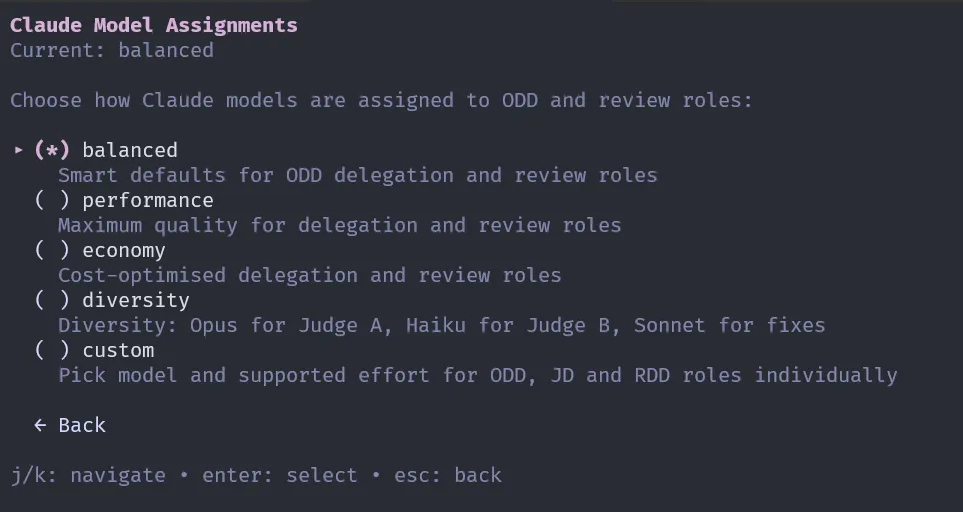
Si seleccionas Custom, puedes armar tu propia configuración. Por ejemplo, puedes elegir que se use Fable, Opus o Haiku para el rol que quieras.
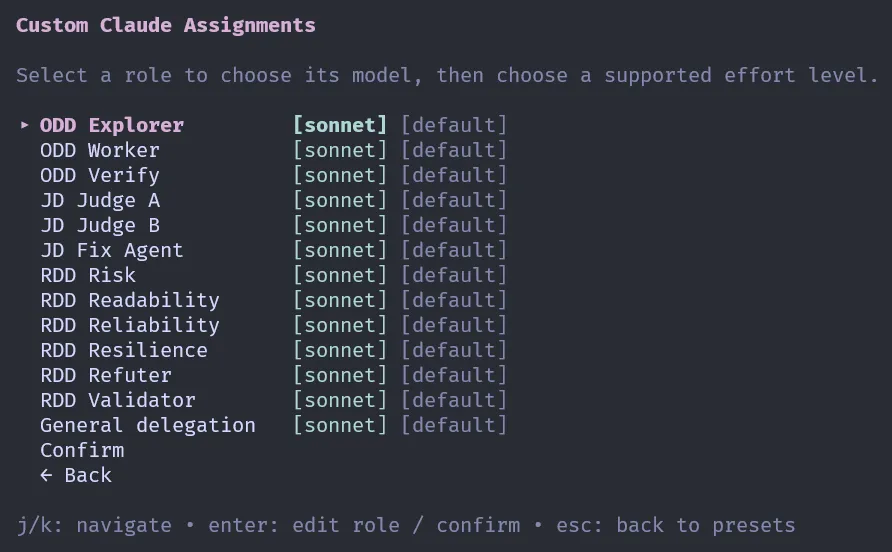
Para Codex verías algo así:
Esto es lo principal. Cuéntame, ¿piensas usar Gentle-AI en tu día a día? ¿Ya lo estás usando? ¿Cuál ha sido tu experiencia? 💬
Y si quieres seguir usando tus agentes lejos de tu PC, te cuento cómo lo hago en Moshi y Herdr: controla tus agentes de IA desde el teléfono. 📱